27届秋招大模型岗面经
27届秋招大模型岗面经
碎碎念
慌死了
面试记录
| 面试 | 时间 | 回忆 | 结果 |
|---|---|---|---|
| 字节-抖音AI搜-一面 | 2026-08-07_11:00 | 有同事对这个团队比较熟悉,做的是 VLM RL 跟我实习工作比较 match | 通过,但是面评说不太熟练 |
| 拼多多-云弧计划算法工程师-一面 | 2026-08-07_15:00 | 上来一个 leetcode hard,业务不问全是八股,都不会,四十分钟结束,感觉寄了 | 挂,但是被隔壁组捞了 |
| 百度-Comate团队-一面 | 2026-08-11_11:00 | 一个做 Code Agent 的团队,问了 GRPO 相关的八股,说我是偏基模的,他们团队主要是做框架的,应该好好准备一下 Code Agent 相关的知识和 Lost in the Middle 相关的工作。面完下午很快就约二面了,冲! | 过 |
| 百度-Comate团队-二面 | 2026-08-12_14:00 | 主要问的我都是 Memory 相关的问题,实话说准备的不太充分。最后没有算法考的是一个思维题。 | 过 |
| 阿里-淘天-供给智能-一面 | 2026-08-13_20:00 | 主要问的都是简历里的项目,包括实习、横向和论文。面试官对 LlamaFactory 比较感兴趣,问了我是怎么设计实验的,比如“论文里有哪些 PEFT 方法”、“用了哪些指标”、“你觉得你的实验是公平的吗,从现在的角度来看你应该如何重新设计你的实验”、“训练的因素可能受模型大小、数据量大小、方法不同、超参等影响,如何研究这些因素的效果”。 | 过 |
| 字节-抖音AI搜-二面 | 2026-08-17_17:00 | 一面表现不太好,二面被交叉面了。面试官盯着我的检索论文一直问,问的全都是检索的东西,晕了。好在算法只考了一个跳台阶的方法数量。 | 挂 |
| 拼多多-复活-一面 | 2026-08-18_20:00 | 面试官问的比较全面,有业务有基础的八股、论文、项目。算法考了一个简单的前缀和。 | 挂 |
| Boss直聘-一面 | 2026-08-19_10:00 | 一直在问实习,怀疑是来偷方案的。但是确实暴露出了我实习内容准备不充分的弱点,还是要多想一下我的实习产出多准备一下。没考算法和其他八股。 | 挂 |
| 阿里-淘天-供给智能-二面 | 2026-08-19_20:00 | 还行,压力不是很大,问了我 RL 和 SFT 的经历。笔试是 AI Coding 写一个业务问答 Agent。 | 过 |
| 百度-Comate团队-三面 | 2026-08-20_14:00 | 是一个看起来级别比较高的领导来面试,又问了我“你觉得 Claude Code”的痛点在哪里,聊的还算可以,没考算法题。 | 等通知 |
| 阿里-阿里云-Agent开发-一面 | 2026-08-25_20:00 | 面的是开发岗,准备不太充分大意了,体验不太好。算法考的是快速选择,知道是快速排序但是不会写,问了 ChatGPT 才知道怎么写。 | 挂 |
| 阿里-淘天-供给智能-三面 | 2026-08-27_19:00 | 这次面试的领导据说管120人的团队,聊了一些我的算法训练经历,但是面试官也很关注 Agent 和 RSI,我准备得不太好,应该多看看这部分的。 | 等通知 |
| 阿里-淘天-供给智能-四面 | 2026-09-03_17:30 | HR面,HR发现我念的自我介绍了,总之比较紧张,自我感觉发挥没有太好。 | 等通知 |
| 字节-抖音-一面 | 2026-09-08-14:00 | ||
| 阿里-Token Foundry-千问-一面 | 2026-09-08-17:00 |
八股积累
机器学习基础
常用的激活函数有哪些?(拼多多云弧计划一面)
- Sigmiod
\[\sigma(x) = \frac{1}{1 + e^{-x}}\]
输出范围是 \((0, 1)\),浅层神经网络常用。缺点是绝对值较大的时候导数很小,会出现梯度消失,同时输出不是零中心的。现在的深层神经网络已经很少用。
- tanh
\[\tanh (x) = \frac{e^{x} - e^{-x}}{e^{x} + e^{-x}}\]
输出范围是 \((-1, 1)\),和 Sigmiod 差不多,但是是零中心的,同样存在梯度消失。早期 RNN 用得多。
- ReLU
\[\text{ReLU}(x) = \max(0, x)\]
深度学习很经典的激活函数。优点是计算简单,不会出现梯度消失。缺点是 \(x<0\) 时恒为 0,神经元可能永远无法恢复,也就是所谓的 Dead ReLU。
- GELU
\[\text{GELU}(x) = x \Phi(x)\]
其中 \(\Phi(x)\) 是标准正态分布的累积分布函数。可以把它理解成一种平滑版的 ReLU:ReLU 是直接决定“保留还是丢弃”,而 GELU 会根据输入大小进行一种平滑的概率加权。BERT、GPT 等 Transformer 模型中大量使用 GELU。
- SiLU
\[\text{SiLU}(x)=x\sigma(x)\]
它也是一个平滑的非线性函数,相比 ReLU,负数部分不会直接被截断。近年来很多大模型会使用 SiLU,例如一些 LLaMA 系列模型的 FFN 中就会结合 SiLU 使用。
- SwiGLU
\[\text{SwiGLU}(x) = \text{SiLU}(xW_1)\odot(xW_2)\]
就是在 LLM 的 SiLU FNN 中加入一个 \(W_2\) 旁路,让 \(\text{SiLU}(xW_1)\) 和 \(xW_2\) 按位相乘,再经过一个 \(W_3\)。模型可以通过门控动态控制哪些特征通过,因此现在很多 LLM 都采用 SwiGLU。
flowchart LR
    X["输入 x"] --> A["W₁"]
    X --> B["W₂"]

    A --> C["SiLU"]
    C --> D["逐元素乘 ⊙"]
    B --> D

    D --> E["W₃"]
    E --> Y["输出"]
常用的损失函数(拼多多云弧计划一面)
回归任务
- 均方误差损失 MSE
\[\text{MSE}=\frac{1}{n}\sum (y_{i} - \hat{y}_{i})^2\]
\(n\) 是批次大小,\(y_i\) 是真实值,\(\hat{y}_i\) 是预测。优点是平滑,缺点是误差过大则损失过大。
- MAE
\[\text{MAE}=\frac{1}{n}\sum |y_{i} - \hat{y}_{i}|\]
缺点是在 0 处不平滑,优点是相比 MSE 更加鲁棒。
- Huber Loss
\[L = \left\{ \begin{aligned} & \frac{1}{2}(y_i - \hat{y}_i)^2 &, |y_i - \hat{y}_i| \leq \delta\\ & \delta \cdot |y_i - \hat{y}_i| - \frac{1}{2}\delta^2 &, |y_i - \hat{y}_i| > \delta \end{aligned} \right.\]
兼顾了 MSE 的平滑性和 MAE 的鲁棒性。
分类任务
- 二分类交叉熵损失(BCE)
\[L = -y\log(\hat{y}) - (1-y)\log(1-\hat{y}) = \left\{ \begin{aligned} & -\log(1-\hat{y}) &, y=0\\ & -\log(\hat{y}) &, y=1 \end{aligned} \right.\]
不仅用于二分类,也可以用于多标签分类,多标签分类中模型输出的 logit 会经过一个 Sigmiod 得到概率 \(\hat{y}\)。
- 交叉熵损失
\[L =- \sum\limits^{C}y_c\log\hat{y}_c\]
对于独热标签的多分类问题,错误答案的 \(y_c\) 都是 0: \[L=-\log \hat{y}_y\] 也就是模型给正确答案的概率越高,\(L\) 越小。
对比学习
- InfoNCE
\[L=-\log \frac{ e^{\mathrm{sim}(q,d^+)/\tau} }{ e^{\mathrm{sim}(q,d^+)/\tau} +\sum_j e^{\mathrm{sim}(q,d_j^-)/\tau} }\]
拉近正样本,推远负样本。其中 \(\tau\) 是温度,控制 Softmax 的尖锐程度。
- Triplet Loss
\[L=\max(0,d(a,p)-d(a,n)+m)\]
挖坑
大模型算法
Transformer模型架构
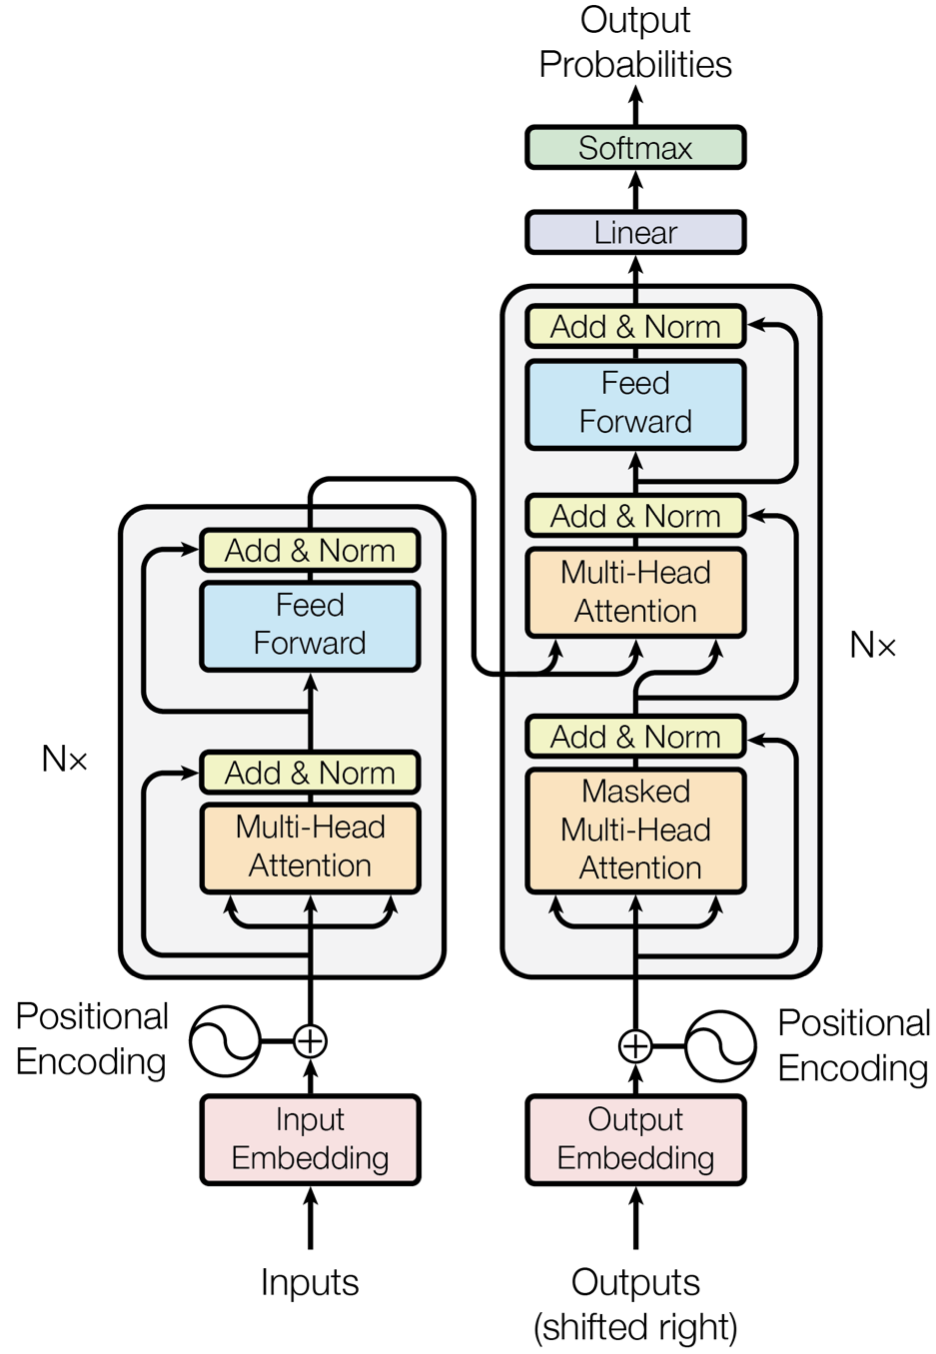
Transformer 的核心思想是:使用 Attention 建模序列中任意两个 token 之间的关系,并通过堆叠多个 Transformer Block 逐层提取特征。 原始 Transformer 采用 Encoder-Decoder 架构,而 GPT、LLaMA 等生成式大模型通常只保留 Decoder,使用 Causal Attention 进行自回归生成。
以原始 Transformer 使用的加性位置编码为例,整体流程可以概括为:
输入表示
文本先经过 Tokenizer 转换为 token id,再通过 Embedding 矩阵映射为向量。对于原始 Transformer 的正弦位置编码或 BERT 的可学习位置编码,Token Embedding 与 Position Embedding 是并行得到的,随后逐元素相加:
\[X_0=E_{token}(x)+E_{pos}(0,1,\ldots,T-1)\]
Attention 本身不关心 token 的先后顺序,因此需要额外注入位置信息。Position Embedding 表示每个 token 在序列中的位置,与 Token Embedding 维度相同;二者相加后,输入表示便同时包含 token 的语义信息和位置信息。
Multi-Head Self-Attention
对于输入 \(X\),先通过三个不同的线性变换得到 Query、Key 和 Value:
\[Q=XW_Q,\quad K=XW_K,\quad V=XW_V\]
缩放点积注意力为:
\[\operatorname{Attention}(Q,K,V) =\operatorname{softmax}\left(\frac{QK^T}{\sqrt{d_k}}+M\right)V\]
其中:
- \(QK^T\) 衡量 token 之间的相关性;
- 除以 \(\sqrt{d_k}\) 是为了避免维度较大时点积数值过大,导致 Softmax 进入饱和区、梯度变小;
- \(M\) 是 Attention Mask。Decoder-only 模型使用上三角的 Causal Mask,使第 \(t\) 个 token 只能看到自己和它之前的 token,不能偷看未来信息;
- 对注意力权重做 Softmax 后再加权求和 \(V\),得到每个 token 融合上下文后的表示。
Multi-Head Attention 会把隐藏维度拆成多个头,让不同的头学习不同类型的关系:
\[\operatorname{MHA}(X)=\operatorname{Concat}(head_1,\ldots,head_h)W_O\]
\[head_i=\operatorname{Attention}(XW_Q^{(i)},XW_K^{(i)},XW_V^{(i)})\]
FFN
Attention 负责不同 token 之间的信息交互,FFN 则对每个 token 独立地进行非线性特征变换。原始 Transformer 使用两层全连接网络:
\[\operatorname{FFN}(x)=W_2\operatorname{ReLU}(W_1x+b_1)+b_2\]
FFN 通常先将隐藏维度从 \(d_{model}\) 扩大到更高的中间维度 \(d_{ff}\),经过 ReLU 激活后,再投影回 \(d_{model}\)。同一个 FFN 会独立地作用于序列中的每个 token,各个位置共享相同的参数。
残差连接和归一化
原始 Transformer 使用 Post-Norm,即先执行子层和残差相加,再做 LayerNorm。
三种常见架构
| 架构 | Attention 范围 | 典型模型 | 适合任务 |
|---|---|---|---|
| Encoder-only | 双向 Attention,每个 token 可以看到完整输入 | BERT | 文本分类、序列标注、向量表示 |
| Decoder-only | 单向 Causal Attention,只能看到当前位置及之前的 token | GPT、LLaMA | 文本生成、对话、通用大模型 |
| Encoder-Decoder | Encoder 使用双向 Attention;Decoder 同时使用 Causal Self-Attention 和对 Encoder 输出的 Cross-Attention | T5、BART | 翻译、摘要等 Seq2Seq 任务 |
对于 Decoder-only 模型,经过 \(N\) 个 Transformer Block 后,最后一个隐藏状态通过 Final Norm 和 LM Head 映射到词表维度:
\[P(x_{t+1}|x_{\le t})=\operatorname{softmax}(W_{vocab}h_t)\]
训练时会并行计算所有位置的 Next Token Prediction;推理时则每次生成一个 token,再把它追加到上下文中继续生成。训练可以并行,生成必须自回归串行,这是 Transformer 大模型训练和推理的重要区别。
CLIP 和 VLM
可以把 CLIP 理解成 VLM 里最经典的“图像和文本对齐模型”。它本身不太像现在的多模态大模型那样直接聊天,而是解决一个更基础的问题:
怎么让一张图片和一句话映射到同一个语义空间里,并判断它们是否匹配。
CLIP 的基本结构
挖坑
训练阶段
PT(预训练)
训练原理
PT 一般是从大规模无监督文本开始。
典型流程是:
原始数据 → 数据清洗 → 去重/质量过滤 → Tokenize → 拼接/切块 → Causal LM 训练 → Checkpoint
具体来说:
- 首先收集大量文本,比如网页、书籍、代码、论文等。
- 做数据清洗,包括去重、低质量过滤、敏感内容过滤、语言识别等。
- 用 tokenizer 把文本转换成 token。
- 通常会把多条文本 packing 到固定长度,比如 4K / 8K / 32K token。
- 训练时采用 Next Token Prediction,也就是:
\[L_{PT} = -\sum_{t=1}^{T}\log P_\theta(x_t|x_{<t})\]
PT 的核心特点是:输入和 Label 本质上来自同一段文本,通常所有有效 token 都参与 loss。
SFT:监督微调
训练原理
SFT 一般是在 Base Model 上继续训练,让它学会 Instruction Following。
数据一般是这种形式:
1 | |
流程是:
Instruction 数据 → 格式统一 / Chat Template → Tokenize → 构造 Labels / Loss Mask → Fine-tune → Instruct Model
其中和 PT 最大的区别之一是 loss mask。
也就是:
- System 不计算 loss
- User 不计算 loss
- Assistant Response 计算 loss
因此 SFT 的目标通常可以写成:
\[L_{SFT} = -\sum_{t\in \text{Response}} \log P_\theta(y_t|x,y_{<t})\]
其中 \(x\) 是 instruction/context,\(y\) 是模型回答。
PT 和 SFT 的区别
| PT | SFT | |
|---|---|---|
| 数据 | 海量无标注文本 | 高质量指令-回答数据 |
| 数据规模 | TB 级、万亿 token | 通常远小于 PT |
| 目标 | 学语言、知识、能力 | 学指令遵循和回答格式 |
| Loss | 通常所有文本 token | 通常只算 Assistant token |
| 模型 | Base Model | Instruct / Chat Model |
| 学习率 | 相对较大 | 通常更小 |
| 训练成本 | 极高 | 相对较低 |
PT 和 SFT 本质上都可以使用 Causal Language Modeling 的 Next Token Prediction 来训练,主要区别在数据和训练目标上。
PT 阶段首先从网页、书籍、代码等来源获取大规模语料,经过清洗、去重、质量过滤后 tokenize,然后通过 packing 构造成固定长度 sequence。训练时通常所有有效 token 都参与 next-token prediction loss,通过大规模训练让模型学习语言规律、世界知识以及基础推理能力,最终得到 Base Model。
SFT 则是在 Base Model 基础上使用高质量 instruction-response 数据继续训练。首先把数据按照统一的 Chat Template 转成 System、User、Assistant 格式,再 tokenize,并构造 loss mask。比较常见的做法是只对 Assistant Response 部分计算 Cross Entropy Loss,System 和 User 部分 label 设置成 -100,不参与 loss。这样模型就能学习在给定用户指令的情况下应该生成什么样的回答。
所以我理解 PT 主要解决的是模型的基础能力问题,而 SFT 主要解决的是指令遵循、输出格式以及行为模式的问题。
如果 SFT 对 USER Prompt 也计算 Loss 会怎么样
如果 User Prompt 也计算 Loss,相当于模型不仅学习“怎么回答”,还在学习“用户怎么提问”。训练依然能收敛,但 Prompt 尤其较长时会占据大量 Loss 和梯度,使有效的 Assistant Response 监督信号被稀释,所以标准 SFT 通常把 User/System token mask 掉,只对 Assistant token 计算 Loss。
PPO
训练原理
PPO 通常涉及 4 个模型:
- Policy Model:正在训练的模型,负责生成回答。
- Reference Model:冻结的参考模型,一般是 SFT 后的模型,用于约束 Policy 不要偏离太远。
- Reward Model:给生成回答打分。
- Value/Critic Model:估计当前位置未来能获得多少 Reward。
PPO(Proximal Policy Optimization)可以理解成:让模型根据 Reward 学习“哪些回答更好”,但每次更新又不能走得太猛。
在 LLM 的 RLHF 里,PPO 通常涉及 4 个模型:
- Policy Model:正在训练的模型,负责生成回答。
- Reference Model:冻结的参考模型,一般是 SFT 后的模型,用于约束 Policy 不要偏离太远。
- Reward Model:给生成回答打分。
- Value/Critic Model:估计当前位置未来能获得多少 Reward。
整体流程大概是:
1 | |
最核心的概念是 Advantage:
\[A_t = \text{实际收益} - \text{Critic 预测收益}\]
如果 \(A_t > 0\),说明这个动作/Token 比预期好,就应该提高它的概率;如果 \(A_t < 0\),就应该降低它的概率。
但如果直接这么训练,一次梯度更新可能把模型改得非常大,所以 PPO 引入概率比:
\[r_t(\theta) = \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{\text{old}}}(a_t|s_t)}\]
Policy Loss 核心是:
\[L^{PPO} = -\mathbb E[ \min( r_t A_t, \operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A_t ) ]\]
这里的 clip 是 PPO 最关键的地方。比如某个 Token 是好动作,\(A_t>0\),我们希望提高它的概率。但如果概率比太大,意味着新模型已经把这个动作概率提高太多了,PPO 会进行裁剪,避免模型一步更新过猛。
除此之外,LLM PPO 通常还会加入 KL 惩罚:
\[R = R_{\text{RM}} - \beta D_{KL}(\pi_\theta || \pi_{\text{ref}})\]
也就是说:Reward Model 希望模型往高奖励方向走,KL 则拉着模型不要离 SFT 模型太远。
为什么 PPO 都使用 clip 了还要取一个 min
因为 clip 只负责构造一个受限的候选目标,min 才负责选择更保守的目标。PPO 实际上是在最大化下面的 Surrogate Objective:
\[L_t^{\text{unclip}}=r_t A_t\]
\[L_t^{\text{clip}}=\operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A_t\]
最终取:
\[L_t^{\text{PPO}}=\min\left(L_t^{\text{unclip}},L_t^{\text{clip}}\right)\]
这里的 min 可以理解为:只保留对当前 Policy 更不利的那个结果,避免模型因为一次更新获得过大的“虚假收益”。例如:
- 当 \(A_t>0\) 时,说明这个 Token 是好动作,模型希望提高它的概率。如果 \(r_t>1+\epsilon\),min 会选择 clipped 项,把收益限制在 \(1+\epsilon\);如果 \(r_t<1-\epsilon\),则保留原始项,继续提供增大该 Token 概率的梯度。
- 当 \(A_t<0\) 时,说明这个 Token 是坏动作,模型希望降低它的概率。如果 \(r_t<1-\epsilon\),min 会选择 clipped 项,限制概率下降幅度;在其他情况下保留原始项,继续推动模型降低该 Token 的概率。
如果只使用 \(L_t^{\text{clip}}\),那么 \(r_t\) 超出区间的两侧都会变成常数,连“需要纠正的方向”也没有梯度。例如 \(A_t>0\) 且 \(r_t<1-\epsilon\) 时,单独使用 clip 会阻止模型继续提高好动作的概率。min 只在有利方向越过阈值时截断,因此既保留正常更新的梯度,又限制单次更新幅度。
所以,clip 负责限制更新范围,min 负责选择保守目标;两者配合才构成 PPO 的 Clipped Surrogate Objective。由于文章中的 \(L^{PPO}\) 前面带有负号,实际训练时是最小化负的这个目标。
DPO
训练原理
DPO(Direct Preference Optimization)可以理解成:不用 Reward Model,也不用 PPO 的 Critic,直接拿“好回答 vs 坏回答”的偏好数据训练模型。
典型数据长这样:
\[(x, y_w, y_l)\]
其中:
- \(x\):Prompt
- \(y_w\):chosen / preferred response
- \(y_l\):rejected response
DPO 的目标很直观:让模型更倾向于 chosen,同时更不倾向于 rejected。
DPO 常见目标函数是:
\[L_{\mathrm{DPO}} = -\log \sigma \left( \beta \left[ \log\frac{\pi_\theta(y_w|x)}{\pi_{\rm ref}(y_w|x)} - \log\frac{\pi_\theta(y_l|x)}{\pi_{\rm ref}(y_l|x)} \right] \right)\]
看起来复杂,其实拆开非常简单。
先定义:
\[r_w= \log\frac{\pi_\theta(y_w|x)} {\pi_{\rm ref}(y_w|x)}\]
\[r_l= \log\frac{\pi_\theta(y_l|x)} {\pi_{\rm ref}(y_l|x)}\]
DPO 就希望:
\[r_w > r_l\]
也就是:相对于 Reference Model,当前 Policy 应该更加偏爱 chosen,而不是 rejected。
DPO 是一种基于 preference pair 的直接偏好优化方法。训练数据由 prompt、chosen response 和 rejected response 构成。它不需要像 PPO 一样单独训练 Reward Model 和 Critic,而是通过比较 Policy 相对于 Reference Model 在 chosen 和 rejected 上的 log probability ratio,让 chosen 的相对概率提升得更多。
GRPO
训练原理
GRPO(Group Relative Policy Optimization)可以理解成去掉 Critic 的 PPO:针对同一个 Prompt 采样多个 Response,根据这一组 Response 的 Reward 计算相对 Advantage,然后继续使用 PPO 的概率比和 clip 机制更新 Policy,同时用 KL 惩罚约束 Policy 不要偏离 Reference Model 太远。
GRPO 通常涉及 3 个角色:
- Policy Model:正在训练的模型,负责生成 Response。
- Reference Model:冻结的参考模型,通常是 SFT 后的模型,用于计算 KL 惩罚。
- Reward Model / Verifier:给 Response 打分,可以是 Reward Model、答案校验器、代码测试用例或其他环境反馈。
GRPO 不需要额外训练 Value/Critic Model,这也是它相对 PPO 节省显存和计算资源的主要原因。
给定一个 Prompt \(x\),从旧策略 \(\pi_{\theta_{\text{old}}}\) 中采样 \(G\) 个 Response:
\[y_i=(y_{i,1},y_{i,2},\dots,y_{i,|y_i|}), \quad y_i \sim \pi_{\theta_{\text{old}}}(\cdot|x), \quad i=1,\dots,G\]
然后计算每个 Response 的 Reward:
\[R_i=R(x,y_i)\]
GRPO 不直接使用 Reward 的绝对值,而是在同一个 Prompt 的多个 Response 内进行标准化:
\[\bar R=\frac{1}{G}\sum_{i=1}^{G}R_i\]
\[\sigma_R=\sqrt{\frac{1}{G}\sum_{i=1}^{G}(R_i-\bar R)^2}\]
\[A_i=\frac{R_i-\bar R}{\sigma_R+\delta}\]
其中 \(A_i\) 就是组内相对 Advantage,\(\delta\) 是防止除零的很小的常数。对于 Outcome Supervision,整个 Response 中的 Token 共用同一个 Advantage:
\[A_{i,t}=A_i\]
因此,如果某个 Response 的 Reward 高于组平均值,就提高其中 Token 的概率;如果低于组平均值,就降低其中 Token 的概率。
对于第 \(t\) 个 Token,GRPO 沿用 PPO 的概率比:
\[r_{i,t}(\theta) = \frac{\pi_\theta(y_{i,t}|x,y_{i,<t})} {\pi_{\theta_{\text{old}}}(y_{i,t}|x,y_{i,<t})}\]
GRPO 的目标函数可以写成:
\[L^{\mathrm{GRPO}} = -\mathbb E\left[ \frac{1}{G}\sum_{i=1}^{G}\frac{1}{|y_i|}\sum_{t=1}^{|y_i|} \min\left( r_{i,t}(\theta)A_{i,t}, \operatorname{clip}(r_{i,t}(\theta),1-\epsilon,1+\epsilon)A_{i,t} \right) -\beta D_{KL}(\pi_\theta\|\pi_{\text{ref}}) \right]\]
这里:
- \(r_{i,t}(\theta)\) 用于比较新旧 Policy 对该 Token 的概率;
- clip 防止一次更新幅度过大,和 PPO 中的作用相同;
- \(D_{KL}(\pi_\theta\|\pi_{\text{ref}})\) 防止当前 Policy 偏离 Reference Model 太远;
- \(\beta\) 控制 KL 惩罚的强度。
GRPO 和 PPO 的关键区别只有 Advantage 的来源不同:
\[\text{PPO: } A_t=\text{实际收益}-\text{Critic 预测收益}\]
\[\text{GRPO: } A_i=\frac{R_i-\operatorname{mean}(R)}{\operatorname{std}(R)}\]
GRPO 是 PPO 的一种变体。它针对同一个 Prompt 采样多个 Response,根据组内 Reward 的均值和标准差计算相对 Advantage,从而替代 PPO 中由 Critic 估计的 Advantage;随后仍然使用 PPO 的概率比裁剪机制更新 Policy,并通过 Reference Model 的 KL 惩罚限制模型偏离原始策略。
GRPO 过程中如何控制工具调用轮数
大模型应用开发
Code Agent(百度 Comate)
Code Agent 的执行流程
Code Agent 的执行流程可以概括成一个 “理解 → 定位 → 修改 → 执行 → 验证 → 迭代” 的闭环。
- 理解任务:先分析用户需求,明确要修改什么、目标是什么、有哪些约束。
- 探索代码库:通过
ls / glob / tree看项目结构,再用grep / rg / LSP搜索相关函数、类和调用链。 - 读取上下文:通过
Read读取相关代码、配置文件、测试代码,理解现有实现和问题原因。 - 制定修改方案:判断应该改哪些文件、影响范围多大,尽量做最小必要修改。
- 执行代码修改:通过
Edit / Write修改代码,必要时新增文件或配置。 - 运行验证:使用 Shell
执行单测、编译、lint、运行程序等,例如
pytest、npm test。 - 根据反馈迭代:如果测试失败,就读取报错、日志或 traceback,重新定位问题并继续修改。
- 最终检查:通过
git diff查看改动,确认没有引入无关修改,测试通过后输出结果。
可以记成一个非常简洁的流程:
flowchart LR
    A[接收任务] --> B[理解需求]
    B --> C[搜索并阅读代码]
    C --> D[制定修改方案]
    D --> E[修改代码]
    E --> F[运行与测试]
    F --> G[观察执行结果]

    G --> H{是否成功?}

    H -->|失败| C
    H -->|成功| I[检查改动并完成]
其中最关键的一点是:Code Agent 不是一次性生成代码,而是基于工具执行结果不断 Observe → Reason → Act,形成闭环。
Code Agent 常用的工具
Code Agent 的工具大体可以分成下面几类:
| 类别 | 常见工具 | 主要作用 |
|---|---|---|
| 文件系统工具 | Read / Write / Edit / Glob | 读取、创建、修改文件,查找目录和文件 |
| 代码搜索工具 | Grep / ripgrep / AST Search | 搜索符号、函数调用、字符串和代码引用 |
| Shell / Terminal | Bash / Shell | 执行命令,是 Code Agent 最核心的通用工具之一 |
| 代码执行工具 | Python / Node / Compiler | 实际运行代码、脚本和编译项目 |
| 测试工具 | pytest / unittest / npm test 等 | 自动验证代码修改是否正确 |
| Git 工具 | git diff / status / log / commit | 查看修改、历史版本、代码差异 |
| GitHub 工具 | PR / Issue / Actions | 阅读 Issue、处理 PR、查看 CI 结果 |
| Web / 文档搜索 | Web Search / Fetch / Docs | 查询 API 文档、依赖库用法和错误信息 |
| 浏览器工具 | Browser / Playwright | 调试 Web 应用、验证页面行为 |
| LSP / IDE 工具 | Definition / References / Diagnostics | 跳转定义、查找引用、获取编译和类型错误 |
其中最基础、最核心的通常就是:
Read / Edit + Grep + Shell。
因为实际上很多 Code Agent 都可以通过 Shell 间接完成大量操作,比如:
1 | |
所以从 Agent 设计角度看,Shell 本身就是一个能力非常强的通用工具。
总结:
Code Agent 常用工具主要有几类:第一类是文件系统工具,比如 Read、Write、Edit、Glob;第二类是代码检索工具,比如 Grep、ripgrep,用来定位函数和调用关系;第三类是 Shell,可以执行 Python、编译、pytest 等命令;第四类是 Git/GitHub 工具,用来查看 diff、commit、PR 和 CI;另外还可能有 Web Search、Browser、LSP 等工具。
我觉得 Code Agent 最核心的其实是 Read/Edit + Search + Shell。它通过这些工具形成“搜索代码—读取上下文—修改代码—执行测试—根据结果继续修改”的闭环,这也是 Code Agent 相比普通代码生成模型最大的区别。
你觉得 Claude Code 还存在哪些问题
挖坑
Agent Memory
Agent Evaluation
大模型框架
LlamaFactory
vLLM(百度)
为什么使用 vLLM?
v1 相比 v0 有什么变化
OOM 了怎么排查
算法题
编程题
腾讯元宝实习一面【162. 寻找峰值】 在提示之前,没做出来,提示了写的也是磕磕绊绊
腾讯元宝实习二面【79. 单词搜索】 DFS 简简单单
字节抖音AI搜一面【5. 最长回文子串】 先写了一下朴素方法,然后用中心扩散写出来了
拼多多云弧计划一面【750. 角矩形的数量】 写的不好,只会朴素方法
百度Comate一面【92. 反转链表 II】 写出来了,但是代码比较复杂不太熟练
淘天供给智能一面:给你公式实现 RRF 召回融合,简单
字节抖音AI搜二面【70. 爬楼梯】简单的 DP
拼多多-复活-一面【应该是自己出的题】前缀和秒了
淘天供给智能二面:AI Coding 写一个业务 Agent
思维题
百度Comate二面
你站在悬崖上面,前面是狼群。悬崖高 200 米,悬崖顶上和中间 100 米处各有一棵树;你有 150 米绳子和一把刀。如何安全下去?
淘天供给智能三面
54张扑克牌,随机分为三摞各17张,大小王在同一摞的概率是多少?